2026 年 9 月 15 日,TypeSafe AI 发布了一个名叫 Jev 的 AI 模型。Jev 不是在通用模型能力上更进一步,而是在决策判定这个细分领域单开了一页。在一个所有人都在卷生成能力的时代,TypeSafe AI 选择了一条完全不同的路,专注于解决工程落地中对快速、准确且结构化的决策判定的诉求。
Jev 绝不仅仅是一个特别快、特别便宜的分类模型,它真正的目标是:AI 的输出是否可以不再是自然语言文本,而是直接成为程序控制流中的类型化值? 所以我认为 Jev 是一种新的 AI 基础设施:判定模型(Decision Model)。
一、TypeSafe AI 的团队背景与产品定位
Jev 背后的公司 TypeSafe AI 由三位联合创始人创立。CEO Diogo Almeida 是前 OpenAI 研究员,参与了强化学习和 ChatGPT 的早期开发。CTO Erik Spock Gafni 和 COO Sasha Sheng 同样来自 OpenAI。团队 2024 年成立后进入隐身模式,直到 2026 年 9 月带着产品 Jev 亮相。
TypeSafe 给自己的定位是“machine-native AI”。当前的大模型都在卷推理生成能力,企图通过训练出更强的大脑来更好的完成任务,但 TypeSafe 反过来思考:AI 费劲心思生成的完美结果其实是给人看的,但 AI 的服务主体是大量的工程应用,而工程应用不需要优美的文字,它需要的只是快速、准确、结构化的判定结果。例如,一个客服工单进来,工程关心的不是“请详细解释为什么这个工单应该交给退款团队”,而是直接根据 {"department": "refund", "confidence": 0.93} 这样的判定理论,然后直接执行 if (confidence > 0.9) { routeToRefund(); } ,路由到退款团队。
这个定位背后还有一个深层的判断,就是当前 AI 存在过度自信的问题。人类读者可以批判性地看待模型的回答,但在没有人类参与的自动化链路里,过度自信的输出会导致连锁错误。Jev 试图通过带概率的类型化决策来解决这个问题。
从行业时机看,Agent 系统正在从“单轮问答”走向“多步执行”,多步执行意味着大量高频、低延迟的判断,比如识别、路由、门控、验证、风险识别、工具选择等。这些任务全部交给生成式大模型,成本和延迟都会成为瓶颈。TypeSafe 的理念就是AI 能力需要分层,一部分模型专门负责判断,另一部分负责生成与推理。
二、Jev 设计范式
传统方式下,让 GPT 判断“这个用户是否要求退款”,模型返回一段自然语言,工程代码再从中提取信息、解析 JSON、校验字段、处理异常、必要时重试,最后才进入业务逻辑:
1 | Input → Model → Text → Parser → Business Logic → Action |
Jev 的目标是把这条链路压缩成:
1 | Input → Decision Model → 0.95 → if probability > threshold → Action |
Noul 返回的 0.95 直接映射到一个 if,Choice 返回的 "refund" 直接映射到一条路由,Score 返回的位置直接映射到一个阈值判断。这些能力本质上是语义函数(Semantic Function)的功能体现:把自然语言理解能力封装成程序可以直接调用的类型化接口。
1 | GenerationModel: Prompt → Tokens |
State是结构化输入,可以是字符串、JSON 对象或数组;Question是对某个判断的自然语言定义;TypedAnswer是带概率语义的类型化值。
生成模型的消费者是人类,Decision Model 的消费者是程序控制流。这决定了两者在训练目标、评估指标、延迟和可靠性要求上的根本差异。
TypeSafe 坚持主流 LLM 逐 token 生成,做的是慢且复杂的推理分析工作;Jev 只负责接收输入后直接给出判定,不生成回复、不产出代码、不解释推理过程,目前只支持文本输入。可以这样理解,快速的语义判定负责路由、门控和分类,深度推理负责规划与生成,两者互补。
三、Jev 三种判定原语
原语(Primitives)是 TypeSafe 文档中最有技术含量的部分。每个原语由一个问题(Question)和一个类型化回答(Answer)组成,共三种:
Choice 回答“选哪个”。答案在一组已知、无序的选项中:工单分给哪个团队、文档属于什么类型。开发者提供选项列表和每个选项的描述,模型返回选中的选项、完整概率分布和一个置信度。它本质上是 P(class | state, question),关键区别在于分类任务在运行时定义,而不是固化在模型参数里,也就是说,同一个 Jev 可以做客服分类、意图分类、风险分类,无需为每个任务训练模型。
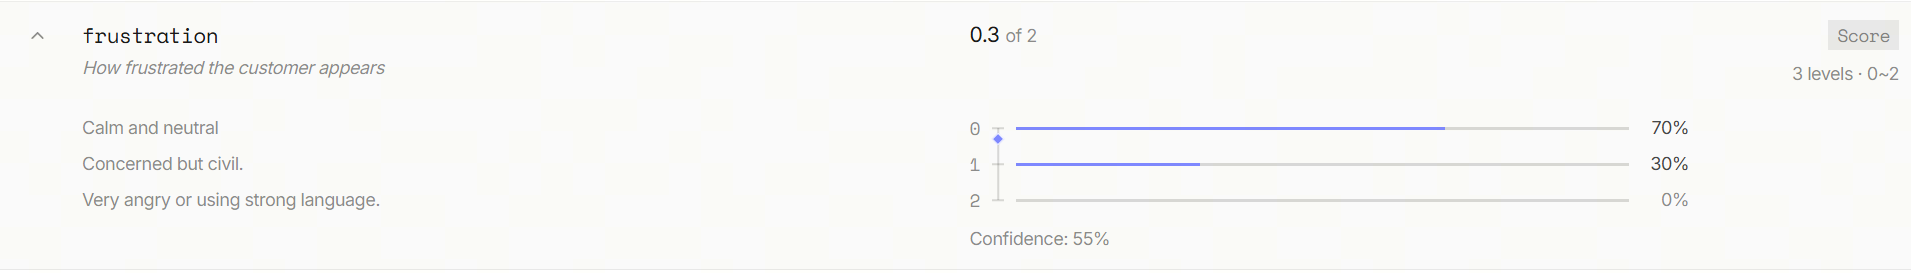
Score 回答“什么程度”。答案在一个你能描述每个位置含义的光谱上:Bug 严重程度、客户愤怒程度。开发者定义有序级别,模型返回在级别上的位置(可以落在两个级别之间)、概率分布和置信度。
Noul 回答“是不是”。模型返回 0 到 1 之间的概率,接近 1 为“是”,接近 0 为“否”,接近 0.5 为不确定。Noul 没有单独的置信度字段,因为概率本身同时承载了答案和确定性。
选择逻辑:从集合中选一个用 Choice,衡量程度用 Score,是非判断用 Noul;两种都合适时,优先选你的代码能直接 act on 的那个。
Python SDK 调用示例:
1 | from typesafe_sdk import Choice, Noul, Score, TypeSafeClient |
一次请求问了三个不同类型的问题,模型并行评估,一次返回三个类型化答案。注意 Score 的 0.23:示例中三个级别看起来被映射到了 0、1、2 的归一化位置,0.23 表示更接近于”Calm”。
四、Jev 置信度坑点
官方文档提到:“如果一个智能系统无法诚实地承认不确定性,这个系统就不值得信任。” 但要用好置信度,必须先厘清三个概念:
- Probability:模型对某个具体判断给出的概率,比如 P(refund) = 0.95。
- Confidence:当前概率分布有多集中。
- Calibration:模型说 90% 的时候,在大量样本上实际正确率是否接近 90%。只有校准良好时,概率才能被当作正确率使用,否则就不要轻易使用原生的概率值。
4.1 陷阱:confidence 字段不是正确率
TypeSafe 对 Choice 返回的置信度按下式计算:
1 | confidence = (n × peak - 1) / (n - 1) |
其中 n 是选项数,peak 是最大概率。当分布完全均匀(peak = 1/n)时 confidence = 0,当 peak = 1 时 confidence = 1。它是 peak 的线性归一化,本身没有问题,问题在于开发者可能会顺手写出:
1 | if answer.confidence > 0.9: |
并期望这意味着 90% 以上的把握。这是错的。同一个 confidence 阈值,在不同选项数下对应的正确率完全不同:
| 选项数 n | confidence = 0.5 → peak | confidence = 0.9 → peak |
|---|---|---|
| 2 | 0.750 | 0.950 |
| 3 | 0.667 | 0.933 |
| 5 | 0.600 | 0.920 |
| 10 | 0.550 | 0.910 |
| 16 | 0.531 | 0.906 |
两个直接后果:
- confidence 系统性地显得比实际更不自信。一个校准完美的模型在 16 选 1 时,confidence = 0.5 的样本实际约 53% 正确,而 2 选 1 时是 75%。如果你用 confidence 画可靠性图,会得到一条偏离对角线的曲线,但那不是模型没校准,而是用错了量。
- 阈值不可移植。你为 3 选项任务调好的
confidence > 0.5,在给 Choice 增加到 10 个选项后,风险含义已经变了,而代码里的数字没变。
另外,confidence 只用了 peak,丢掉了第二名的信息。分布 [0.5, 0.5, 0, 0] 和 [0.5, 0.2, 0.2, 0.1] 的 confidence 相同,但前者是在两个选项间犹豫,后者是大体确定但噪声较大,对业务的含义完全不同。
正确做法:
- 校准评估与阈值设定都基于 peak probability(或完整分布),而不是 confidence 字段;
- 对 Noul,正确率对应的是
max(p, 1 - p); - confidence 字段适合做 UI 展示或粗粒度监控,不适合直接驱动自动执行;
4.2 RLCD:概念清晰但无公开测评
Jev 使用 RLCD(Reinforcement Learning for Calibrated Decisions)训练。与 RLHF 关注“人类是否喜欢这个回答不同”,RLCD 关注的是“预测概率与实际结果的匹配程度”,训练目标从 Fluent Generation 转向判定质量(Decision Quality) + 处理校准(Calibration)。
RLCD 的损失函数、样本构造、是否有后处理校准、在哪些数据集上测过 ECE、分布外表现如何,目前都未公开。校准性是 Jev 最强的潜在卖点,但目前仍是【待验证】命题。
五、为什么不直接让 LLM 返回 JSON?
这是我了解 Jev 之后最大的一个疑问,我觉得需要从以下两方面来看:
第一,生成路径。LLM 的 JSON 是自回归生成的,延迟随输出长度增长;Jev 是一次性判定,不经过 token 生成循环。
第二,Schema 合规。主流 API 的 strict structured output 采用约束解码,已经能保证输出符合 schema。Jev 的优势在于类型化是原生输出空间,即你问什么,Jev 就答什么,而且输出类型也是固定的三种。
让 LLM 做判定,更合理的做法是:
- 把每个选项映射为单 token 代号(A、B、C……);
- 要求只输出一个代号,
max_tokens = 1; - 读取第一个 token 在各代号上的 logprobs,做 softmax 得到分布;
- 在验证集上拟合温度 T,完成校准;
这种做法只有一次 prefill 加一步解码,没有长输出,延迟主要由输入长度决定,并且能得到可校准的完整分布(前提是所用 API 开放 logprobs)。Jev 的核心原理就与这个差不多。
| 维度 | LLM 生成 JSON | LLM 单 token logprobs + 温度缩放 | Decision Model(Jev 类) |
|---|---|---|---|
| 生成机制 | 自回归多步 | prefill + 1 步 | 非自回归判定 |
| Schema 合规 | 约束解码可保证 | 天然合规 | 天然合规 |
| 概率来源 | 模型自报,通常不可靠 | token 分布,需自行校准 | 训练目标强调校准,效果 |
| 多问题 | 一次生成多个字段,或多次调用 | 每个问题一次调用(可用 prompt caching 降低成本) | 一次请求并行多个问题 |
| 需要维护 | Prompt + 解析 + 重试 | Prompt + 代号映射 + 校准器 | Question 定义 |
| 适合 | 需要解释或生成 | 已有 LLM 栈、需要强语义理解 | 高频识别、路由、门控、验证 |
也可以说,Jev 的价值就体现在更低的延迟和成本、原生多问题并行、免维护校准器。这是工程便利性上的优势,而不是能力上的代差。
六、Jev 原语使用陷阱
Score 的序数尺度。 Score 的级别只保证顺序,不保证等距。按约定,三个级别位于 0、0.5、1,若 P = 0.1 / 0.3 / 0.6,概率加权位置是 0.75。但“求加权位置”这个操作本身就假设了等距:它把“从 Calm 到 Concerned”和“从 Concerned 到 Angry”视为同样长的距离。因此 Score 的 value 适合排序和粗略比较,不适合做加减或按线性关系设定阈值。符合序数语义的做法是直接使用分布的累积概率,如果业务本质上要的是 Low / Medium / High 三档离散结果,直接用 Choice。
Choice 的闭集强迫选择。 选项里没有 complaint,而用户在投诉服务质量,模型仍必须从 refund / rebooking / information 中选一个,可能以很高的 peak 选错。这不是模型的问题,是标签空间设计错了。生产系统中务必加入 other / none_of_the_above 兜底选项,并在评估集中专门放入分布外样本,测量“高置信误判率”。
Noul 的概率一致性。 问“是否要求退款”得到 0.95,再问“是否没有要求退款”,并不保证得到 0.05。每个 Noul 是针对单个命题的概率,不是一个全局一致的概率模型。这个性质很容易实测,建议在接入前跑一遍。
多问题的条件依赖。 如果 Q2 是“退款金额是否超过 1000 元”,它在语义上以 Q1“是否要求退款”为条件。API 让每个问题独立看到同一个 State,并不建模依赖;把 P(Q1) × P(Q2) 当联合概率是错误的。要么在 Q2 的 instructions 中显式写出条件,要么用代码级联:Q1 通过后再解释 Q2。
置信度聚合。 多个问题一起返回时,不要算一个全局平均置信度,因为它会掩盖关键问题的低置信度。每个问题应有独立的阈值和路由策略,由上一节的成本公式各自推导。
标签空间与锚点的版本管理。 Choice 选项和 Score 级别描述都在运行时定义,这是灵活性,但也是隐患,比如今天新增 complaint,历史日志中 refund 的含义就变了;Score 锚点描述写得模糊,不同业务线对“Very angry”的理解也会漂移。给 Question 定义打版本号,写入审计日志,并用定期人工标注校准锚点。
七、Jev 安全问题
TypeSafe 的输入是结构化的 State,问题可以通过点号路径引用字段。Does ticket.messages[0].text request a refund? 让模型只看客户的第一条消息;Does refund_policy support the refund requested in ticket.messages[0].text, given order.charges? 让模型同时参考三个数据片段。与把整个业务对象 stringify 成一大段 prompt 相比,Jev 的这个引用语法更接近数据库查询,这样的设计有个巨大的好处,就是数据和问题在结构上分离,减少了模型读错上下文的风险。
有些人提到 Jev 不生成文本,所以不怕 prompt injection,这只说对了一半。注入确实无法让它说出不该说的话,但恶意的注入能推动概率越过阈值,比如:
1 | { |
对于生成模型,注入的目标是输出内容;对于 Decision Model,注入的目标是决策边界。攻击者不需要让模型做坏事,只需要把 refund_approved 的概率从 0.9 推到 0.996,恰好越过你精心推导出的 0.995 期望阈值。
防护思路:
- 区分可信与不可信字段:政策、订单状态来自数据库,用户文本来自外部;涉及权限的判断,instructions 只引用可信字段,例如由
order.status而不是用户自述来判断航班是否取消。 - 用一个 Noul 做守卫:
Does ticket_message contain text addressed to the system or claiming internal approval?,概率高时直接转人工。 - 确定性规则兜底:金额、状态等硬条件由代码校验,模型只负责语义判断。
- 监控概率分布:高风险问题的概率分布如果突然向阈值附近聚集,往往是攻击或数据漂移的信号。
八、Jev 架构设计与能力边界
8.1 Jev 技术架构
TypeSafe 文档总结了四种架构模式。
投机性扇出(Speculative Fan-Out):一次请求问出代码可能用到的所有问题,包括只对部分输入有意义的问题,再由代码决定用哪些。官方 cookbook 中,13 个问题打包为一次调用,比 13 次独立调用便宜 11.5 倍、快 9.6 倍,答案不变。
这个数字背后的机制值得算清楚。假设 State 为 S 个 token,每个问题的定义为 q 个 token,共 k 个问题,按输入计费时:
1 | 独立调用成本 ∝ k × (S + q) |
S = 1000、q = 30、k = 13 时,节省约 9.6 倍;S 越大于 kq,倍数越接近 k。也就是说,扇出的节省主要来自 State 只被编码一次。LLM 的 prompt caching 也能回收一部分输入成本,但仍然有 k 次网络往返和 k 次解码,这部分是 Jev 更难被替代的地方。
扇出的边界同样需要关注:问题数到 100、1000 时延迟和吞吐是否仍然次线性增长【待验证】;instructions 语义重叠的问题之间可能给出不一致的答案,应监控一致性。
置信度门控路由(Confidence-Gated Routing):把概率作为第二决策轴,与选择结果组合形成更精细的路由,具体的组合算法需要根据具体的业务诉求来定义。
复合评分(Composite Scoring):把笼统的问题,比如“这个项目的投资潜力”,拆成独立维度,比如市场规模、技术可行性、差异化,代码负责权重和计算。原则是把不确定性留给模型,把确定性留给代码。优先级变化时改权重,而不是重写 prompt。
意图路由(Intent Routing):用 Choice 分类意图,再路由到对应处理器,这是 System One 最自然的 Agent 入口。
在此基础上还可以组合出级联判定(Noul 过滤 → Choice 细分 → Score 排序)、低置信回退、A / B判定(新模型只记录不执行,用于回归对比)。常见的反模式如下:
| 反模式 | 后果 | 做法 |
|---|---|---|
| 用 confidence 字段直接做阈值 | 阈值含义随选项数漂移 | 用 peak 或完整分布 |
| 所有操作一个阈值 | 高风险操作被自动执行 | 按成本逐操作推导 |
| 独立 Noul 概率相乘 | 联合概率错误 | 显式条件化或级联 |
没有 other 兜底 |
分布外样本被高置信错分 | 加兜底并测 OOS |
| 选项膨胀到几十个 | 区分度下降、成本上升 | 分层 Choice |
| 过度扇出 | 延迟与成本失控 | 监控问题数与 P95 |
| 权限判断引用用户文本 | 决策边界被注入 | 只引用可信字段 |
8.2 Jev 能力边界
- 不适合生成:写邮件、写代码、写 SQL。
- 不适合长链路推理:数学证明、复杂 Debugging、多步规划。
- 不适合没有清晰决策边界的问题:把“这家公司有没有投资价值”强行变成 good / bad,只会制造虚假的精确感。
- 不适合没有稳定 ground truth 的问题:连“什么叫正确”都无法定义,就无法测校准、无法推导阈值。
- 只支持文本:图片、音频、视频判定暂时无法覆盖。
- 置信度无法修复问题设计错误:标签空间错了,模型依然可以在错误的空间里给出高概率。在 Decision Model 范式下,Question 设计是开发者的核心责任。
Jev 最适合的是决策空间可以明确描述,并且最终存在可观察结果(Outcome)的判断任务。
九、Jev 在 Agent 架构中的位置
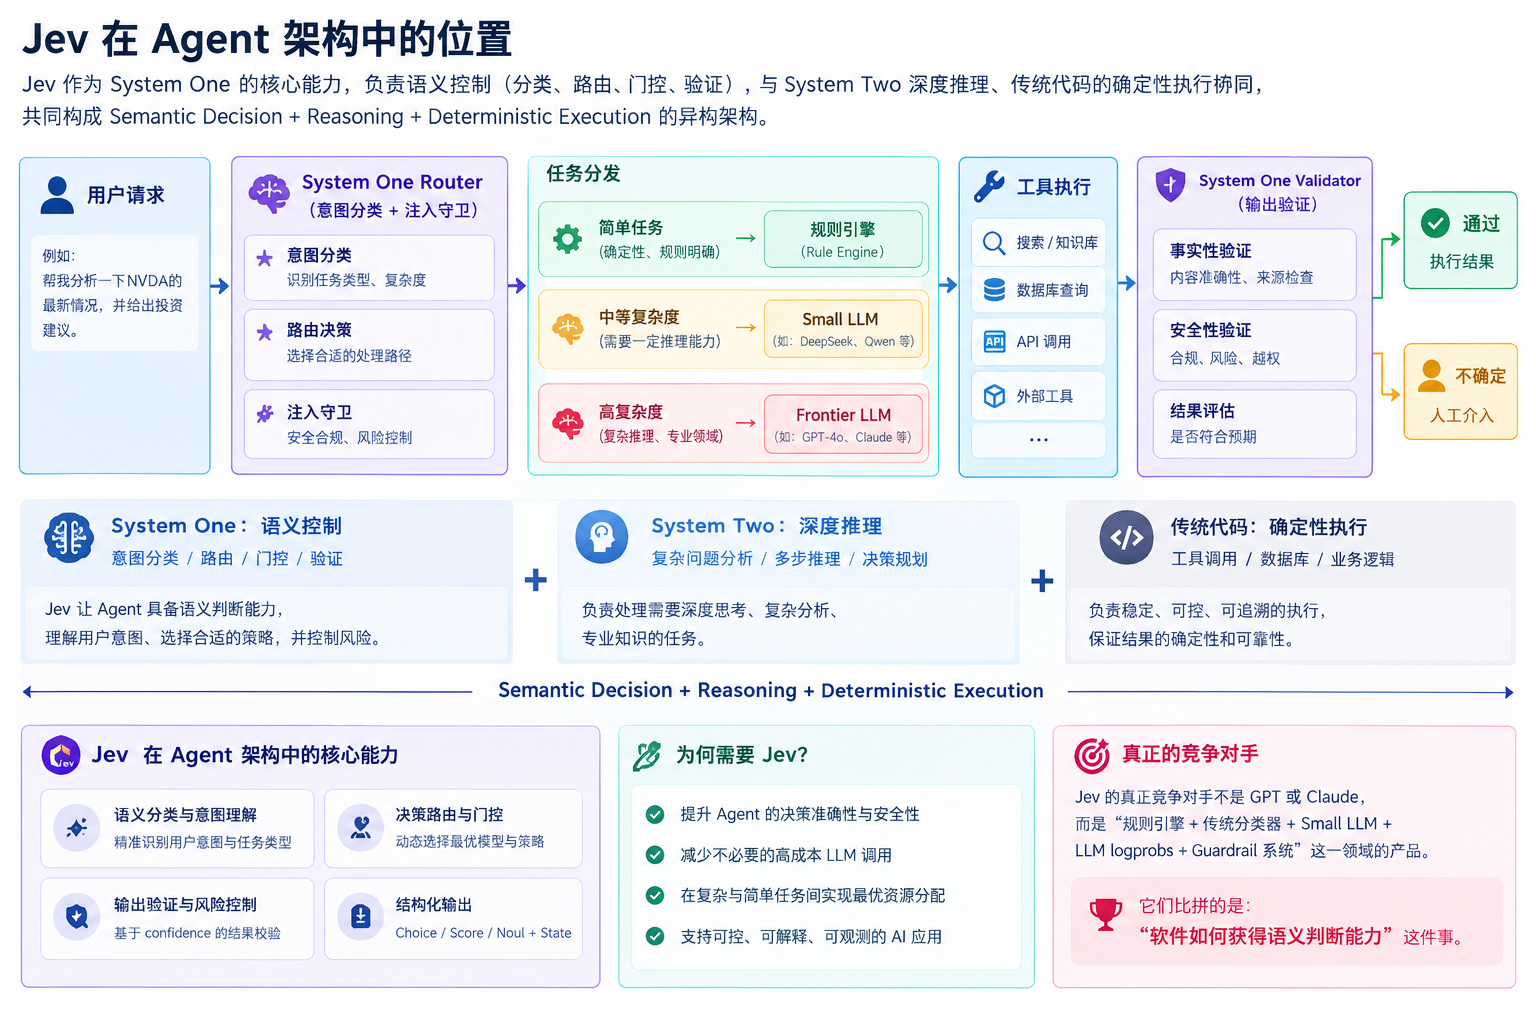
System One 负责语义控制(分类、路由、门控、验证),System Two 负责深度推理,传统代码负责确定性执行,三者形成 Semantic Decision + Reasoning + Deterministic Execution 的异构架构。
因此 Jev 的真正竞争对手不是 GPT 或 Claude,而是“规则引擎 + 传统分类器 + Small LLM + LLM logprobs + Guardrail 系统”这一领域的产品,它们比拼的是“软件如何获得语义判断能力”这件事。
在成本上,真正值得算的不是每百万 token 的单价,而是每完成一次业务任务的总成本:
1 | TCO_task = C_model + C_network + C_parse_retry |
模型调用费往往是最小的一项。以官方输入价 $0.042 / 1M tokens 计算,若每次请求 300 个输入 token,每千次任务的模型费用约为 1000 × 300 × 0.042 / 10⁶ ≈ $0.013。与之相比,把人工升级率降低 1 个百分点、把误执行率降低 0.1 个百分点,对 TCO 的影响通常大得多。这再次说明,决定 Jev 商业价值的是校准与准确率,而不是单价。
此外,还有一个容易被忽略的细节:在 Choice 场景里,选项描述本身就是输入 token。16 个选项、每个描述 15 个 token,就是 240 个 token,可能比用户消息还长。描述写得越详细,区分度越好,成本也越高,这是一个需要权衡的参数。
十、LLM -> Jev 迁移实现
迁移前,一个典型的 LLM + JSON 工单分类器:
1 | import json |
迁移后:
1 | from typesafe_sdk import Choice, Noul, TypeSafeClient |
迁移后消失的是:prompt 中的格式说明、JSON 提取、schema 校验、重试循环、模型自报的置信度。新增的是:兜底选项、注入守卫、按类别推导的阈值、问题定义版本号。所以,代码量未必减少多少,甚至还会增加,但每一行代码的职责都更清楚了。
十一、选型:什么时候该用 Jev
| 方案 | 需要标注训练数据 | 任务能否运行时定义 | 概率可用性 | 最适合 |
|---|---|---|---|---|
| 规则 / 正则 | 否 | 改代码 | 无 | 格式明确、边界清晰 |
| 微调小分类器(DeBERTa、ModernBERT 等) | 每类数百条以上 | 否 | 需自行校准 | 标签稳定、调用量极大 |
| Embedding + 逻辑回归 | 每类数十条起 | 重训很快 | 需校准,LR 本身相对好 | 冷启动、快速迭代 |
| Jev 类 Decision Model | 否(评估集仍然需要) | 是 | 官方强调校准 | 标签常变、多维判断、多租户自定义任务 |
| LLM 单 token logprobs | 否 | 是 | 需温度缩放 | 已有 LLM 栈、语义难度高 |
| LLM 生成 JSON | 否 | 是 | 自报置信度通常不可靠 | 需要解释或生成内容 |
一个粗略的决策顺序:
- 规则能写清楚 → 用规则。
- 标签稳定、有数据、调用量巨大 → 微调小分类器,长期成本最低。
- 标签经常变、任务由运营或客户在运行时定义、一次要判断多个维度 → 这是 Jev 最有优势的区间。
- 需要输出文字或推理过程 → LLM。
注意,不需要训练数据,不等于不需要标注数据。没有评估集,你就无法测量校准,也就无法推导阈值。Decision Model 省掉的是训练集,不是评估集。所以工程级别的评测能力是节省不掉的,还是需要工程团队自己去实现。
十二、Jev 自定义测评
12.1 实验设计
- 数据集:CLINC150(
clinc_oos,plus 配置)中银行领域的 15 个意图,加入 150 条 out-of-scope 样本作为oos类。选它是因为它自带分布外样本,正好能测闭集问题;16 个选项也在 Choice 的合理范围内。 - 中文:官方未说明多语言表现。建议另外人工标注 200–300 条中文工单,重复同一套实验。
- 对比方案:Jev(去掉
oos选项);小 LLM 单 token logprobs(原始 / 温度缩放);小 LLM 生成 JSON(自报置信度);微调小分类器;Embedding + 逻辑回归。 - 指标:Accuracy、Macro-F1、top-label ECE(基于 peak)、ECE(基于 confidence 字段)、Brier、NLL、端到端 P50 / P95 延迟、每千任务成本、OOS 高置信误判率(OOS 样本被以 peak ≥ 0.9 分到某个意图的比例)。
12.2 结果记录表模板
| 方案 | Acc | Macro-F1 | ECE (peak) | ECE (confidence 字段) | Brier | P50 / P95 | $ / 1k 任务 | OOS 高置信误判率 |
|---|---|---|---|---|---|---|---|---|
| Jev | 待测 | 待测 | 待测 | 待测 | 待测 | 待测 | 待测 | 待测 |
| Jev(无 oos 选项) | — | — | — | — | — | — | — | 待测 |
| 小 LLM logprobs(原始) | 待测 | 待测 | 待测 | — | 待测 | 待测 | 待测 | 待测 |
| 小 LLM logprobs(温度缩放) | 待测 | 待测 | 待测 | — | 待测 | 待测 | 待测 | 待测 |
| 小 LLM 生成 JSON(自报置信度) | 待测 | 待测 | 待测 | — | — | 待测 | 待测 | 待测 |
| 微调小分类器 | 待测 | 待测 | 待测 | — | 待测 | 待测 | 待测 | 待测 |
| Embedding + LR | 待测 | 待测 | 待测 | — | 待测 | 待测 | 待测 | 待测 |
12.3 如何解读结果
- Jev 的 ECE (peak) 与温度缩放后的 LLM 基线相比:如果显著更低,校准就是真正的差异化;如果相近,Jev 的价值收敛为“免维护校准 + 低延迟 + 多问题并行”。
- ECE (confidence 字段) 与 ECE (peak) 的差距:预期前者明显更差,并在可靠性图上系统性地偏向对角线上方。这印证了“confidence 字段不能当正确率用”。
- 有无兜底选项时的 OOS 高置信误判率:这个数字直接量化了标签空间设计错误的代价,也是说服团队必须加
other的最好证据。 - P95 延迟与每千任务成本对比微调小分类器:如果微调模型准确率接近而成本低一个数量级,Jev 的定位就是“标签会变的那部分任务”,而不是全部分类任务。
- 如果 Jev 自身 ECE 不理想:同样可以对 log(P) 做温度缩放后再使用。
十三、官方性能数据与解读
- 延迟约 70ms 到 500ms,输入价格 $0.042 / 1M tokens。
- 在 Vercel AI Gateway 上线 24 小时内,近 13% 的付费团队开始使用,成为该平台采用最快的模型。
- 有独立测试者在特定任务上观测到 193 倍速度提升、444 倍成本降低。
- TypeSafe 自有 benchmark 上,Jev 准确率 67.8%,GPT-5.6 Terra 67.9%,GPT-5.6 Sol 74.1%。
API latency ≠ End-to-End latency。 真实请求要经过网关、网络、Agent 框架、工具调用和数据库,70ms 的模型延迟不等于 70ms 的系统响应。应当测端到端 P50 / P95 / P99。
67.8% 这个绝对数字说明不了生产可用性。 最强的对比模型也只有 74.1%,说明这个 benchmark 本身很难,或者 ground truth 含有噪声。有意义的是相对测评的位置:Jev 与 GPT-5.6 Terra 持平,落后 Sol 约 6 个百分点,而延迟和成本低一到两个数量级。你的业务任务上准确率会是多少,只能在你自己的数据上测。
十四、生产化应用
这部分对任何自动决策系统都适用,这里只列出与 Decision Model 关系最密切的要点:
| 能力 | 关键要求 |
|---|---|
| 审计日志 | 记录 State 摘要、Question 版本、完整分布、阈值、最终 Action、模型与 SDK 版本 |
| 版本固定 | 模型、Question 定义、阈值分别版本化;模型升级后必须重测校准 |
| 漂移监控 | 输入分布、概率分布、ECE、人工升级率;ECE 超阈值时告警或回滚 |
| 影子部署 | 新模型或新 Question 定义先只记录不执行,与线上决策对比 |
| 输入安全 | 区分可信与不可信字段,防范决策边界注入,PII 最小化与脱敏 |
| 部署形态 | 金融、医疗、政府场景通常需要 VPC 或专属实例【待验证:官方支持情况】 |
| 人工回退 | 低概率、高风险、疑似分布外、疑似注入都必须能升级到人工 |
| 合规 | 自动决策需提供解释、申诉与人工复核渠道(GDPR、EU AI Act 等),并定期做分群公平性评估 |
十五、个人判断与结论
Jev 当前最值得关注的,不是 70ms 的延迟,也不是 $0.042 / 1M tokens 的价格,这些数字终将被追上。真正值得关注的是:TypeSafe 在尝试把语言模型重新定义成一种可以被软件直接调用的 Decision Model:
1 | 过去:AI = Generate Text 接口:Prompt → Tokens |
Jev 的核心贡献不止于模型本身,还在于一套判定型 AI 的工程方法论:三种原语、概率驱动的路由、投机性扇出与复合评分。这套方法论的价值独立于 Jev 这个具体模型。本文在此基础上补了三件原本缺失的东西:confidence 字段不能当正确率用;阈值应该从误判成本推导;校准可以、也应该在自己的数据上验证。
接下来最值得观察的是三个问题:
- 校准能否成为独立优势。 在与温度缩放后的 LLM logprobs 基线对比时,Jev 能否做到准确率相当、校准明显更好、延迟明显更低。
- 能否形成生态。 Decision Model 与 Agent 框架、可观测性、评估工具、人工审核、工作流引擎能否形成完整链路。
/decision会不会成为标准 API。 如果未来模型 API 同时提供 Generate、Reason、Decide 三种模式,Jev 今天做的事情就是一次 API 抽象的范式变化。
在这些问题得到公开实验和独立验证之前,我更愿意把 Jev 看成一个非常值得关注的技术方向,而不是已经被证明成立的新范式。对工程师来说,最务实的做法,就是挑一个真实的路由或门控场景,用本文的脚本在自己的数据上跑一遍,看校准、端到端延迟、TCO 和 OOS 表现,再决定是否引入生产。
附录 B:参考资料
- TypeSafe AI 官方博客:Introducing System One Models & Jev
- TypeSafe 文档:Primitives(Choice / Score / Noul)
- TypeSafe 文档:Choice Primitive
- TypeSafe 文档:Models and Pricing
- DCVC 领投种子轮融资公告
- Vercel AI Gateway:Jev 采用数据公告
- 独立测试:Jev 速度与成本测试(193× / 444×)
- CLINC150 数据集:Larson et al., An Evaluation Dataset for Intent Classification and Out-of-Scope Prediction, EMNLP 2019
- 温度缩放:Guo et al., On Calibration of Modern Neural Networks, ICML 2017