为什么 SDD 突然火了
2025 年下半年,GitHub 上同时冒出了两个热门项目,都主打同一个概念——SDD(Specification-Driven Development,规格驱动开发)。
| 项目 | Stars | 出品方 | 创建时间 |
|---|---|---|---|
| spec-kit | 87,549 | GitHub 官方 | 2025-08 |
| OpenSpec | 39,543 | Fission AI | 2025-08 |
SDD 这个概念早在 2010 年前后就有人提过,但始终不温不火。它之所以在 2025 年爆发,根本原因是 AI 编码助手的成熟度达到了实用门槛。以前写规格是为了让人理解需求,现在写规格是为了让 AI 理解需求并生成代码。这个转变让 SDD 从锦上添花变成了必备技能。
方法论的演进脉络
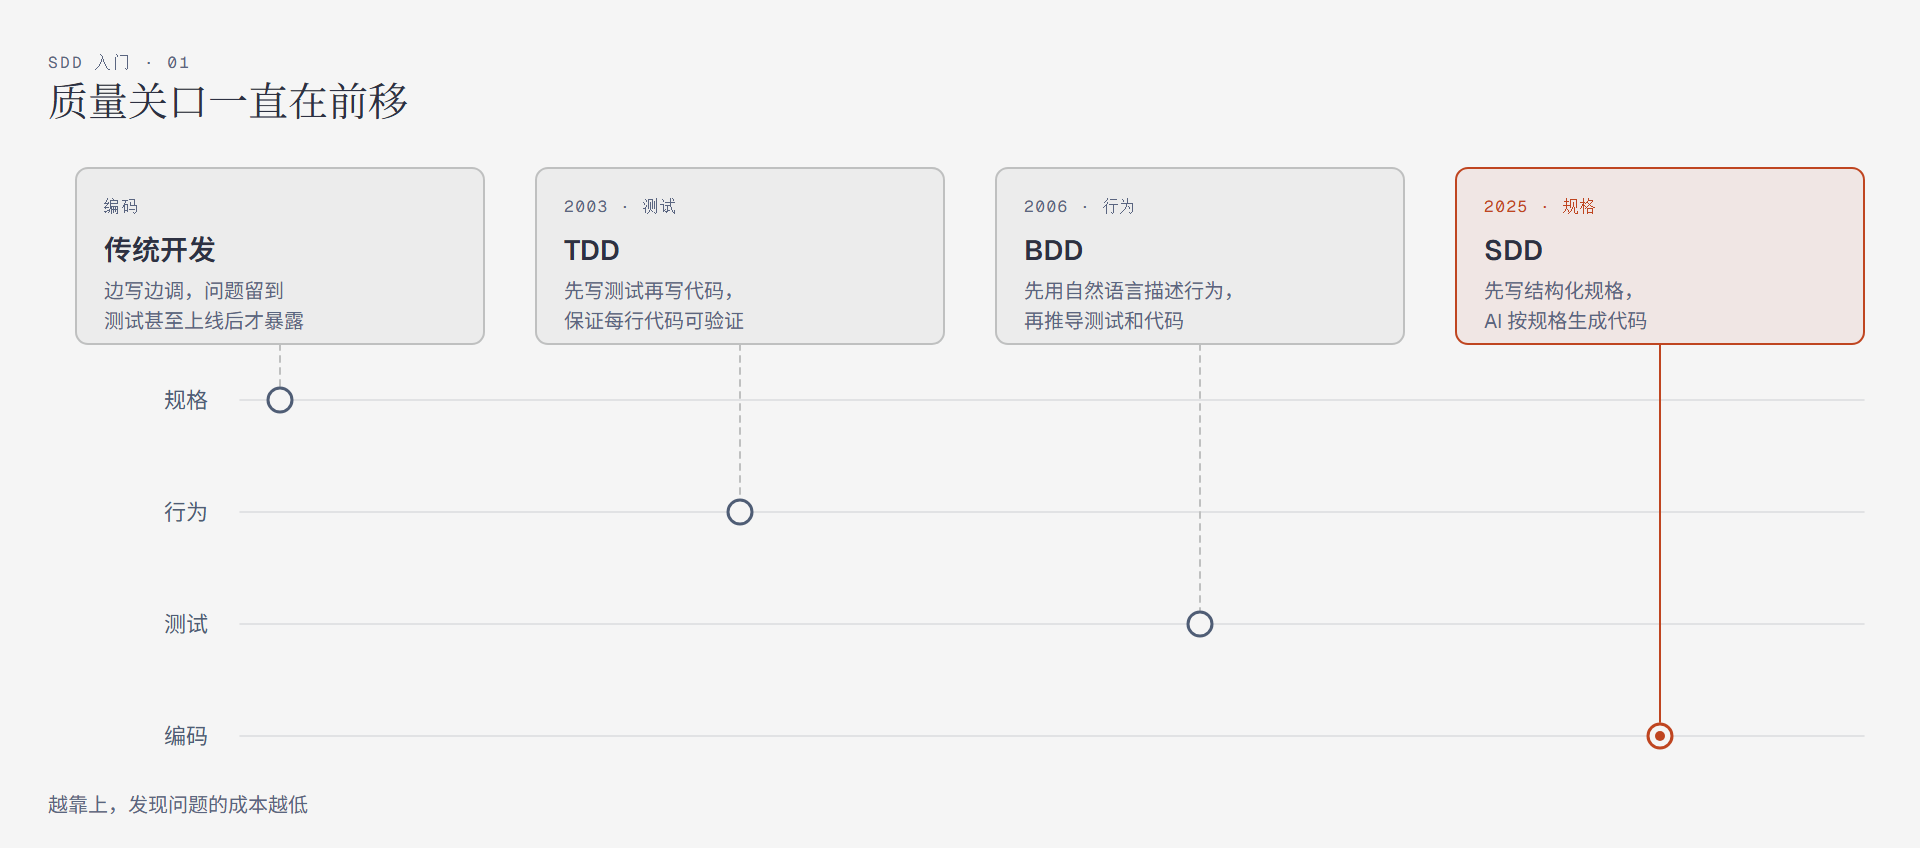
软件开发方法论的演进方向是一致的:把质量保障的关口不断前移。传统开发流程是需求、编码、测试、部署,问题往往在测试甚至部署后才暴露。TDD 在 2003 年提出先写测试再写编码,确保代码可测试。BDD 在 2006 年进一步把起点推到行为描述,用自然语言定义系统应该有什么行为。SDD 则把起点推到了规格层面:先用结构化文档定义清楚要做什么,再让 AI 按规格生成代码。
| 方法论 | 起点 | 核心思路 |
|---|---|---|
| 传统开发 | 编码 | 边写边调试,问题在测试阶段才暴露 |
| TDD | 测试 | 先写测试用例,确保代码可验证 |
| BDD | 行为描述 | 用自然语言描述系统行为,再推导测试和代码 |
| SDD | 规格 | 先写完整规格,让 AI 按规格生成代码 |
SDD 过去不火的原因
SDD 的核心思想是先写规格再写代码,逻辑上很合理,但过去有三个实际障碍阻碍了它的普及。
第一,人写代码比写规格快。资深程序员脑子里有现成的代码模板,直接动手比先写文档效率高得多。第二,规格容易和代码脱节。代码改了,规格忘了同步,最后规格沦为摆设。第三,缺乏工具支撑。规格只是 Markdown 文档,既无法执行也无法验证代码是否符合规格。
这三个问题在 2024-2025 年间被 AI 编码工具逐步解决了。AI 能根据规格自动生成代码,能根据规格变更自动调整实现,也能自动检验代码与规格的一致性。
SDD 爆发的三个条件
| 条件 | 具体变化 |
|---|---|
| AI 编码工具成熟 | Claude Code、Cursor、Copilot 能输出生产级代码 |
| 开发者角色转变 | 从代码编写者变成规格设计者加代码审查者 |
| 工具链完善 | spec-kit 和 OpenSpec 为规格提供了完整的执行框架 |
行业预测到 2026 年,80% 的开发者将常态化使用 AI 编码工具,花在规格设计和架构上的时间会超过写代码本身。
SDD 的核心定义
SDD 的工作方式是先用结构化规格精确描述要做什么,再让 AI 照着规格生成代码,最后验证代码是否符合规格。它的几个核心能力包括:
| 能力 | 说明 |
|---|---|
| 协作澄清 | 开发者有时自己也不清楚需求,AI 协助完成问题定义和方案探索,这是 SDD 最被低估的能力 |
| 规格即契约 | 规格不是参考文档,而是人机之间的契约,AI 必须严格按规格实现 |
| 迭代友好 | 规格可以随时更新,AI 会同步调整代码,不是写完就扔 |
| 验证闭环 | 有工具能验证代码是否符合规格,偏离时自动提醒 |
| 追溯性强 | 每一行代码都能追溯到对应的规格条款 |
协作澄清:最被低估的能力
很多人以为 SDD 的流程是开发者先写清楚规格再让 AI 照做。但现实情况是开发者往往也不清楚自己要什么。传统模式假设开发者想清楚了再写规格再让 AI 实现,但 SDD 的澄清模式更贴近真实场景:开发者有一个模糊的想法,AI 通过提问协助澄清,双方共同定义问题,探索可能的方案,最后形成规格让 AI 去实现。
类比来说,传统模式像你拿着一份完整的菜单去餐厅让厨师照做,澄清模式像你说想吃点清淡的,然后厨师和你讨论是汤还是蒸菜、有什么忌口,最后一起确定菜单。/speckit.clarify 和 /opsx:explore 这类命令的价值就在这里:AI 不是被动执行者,而是主动的需求澄清伙伴。
澄清过程本身就是在定义问题。很多 Bug 的根因不是代码写错了,而是需求本身就没想清楚。
规格的文件结构
两个工具的目录布局差别很大,一开始容易看晕。spec-kit 以功能为单位,一个功能一个编号目录;OpenSpec 把长期规格和短期变更分开,长期规格记录系统现在怎么工作,变更规格只记录这次要改什么。
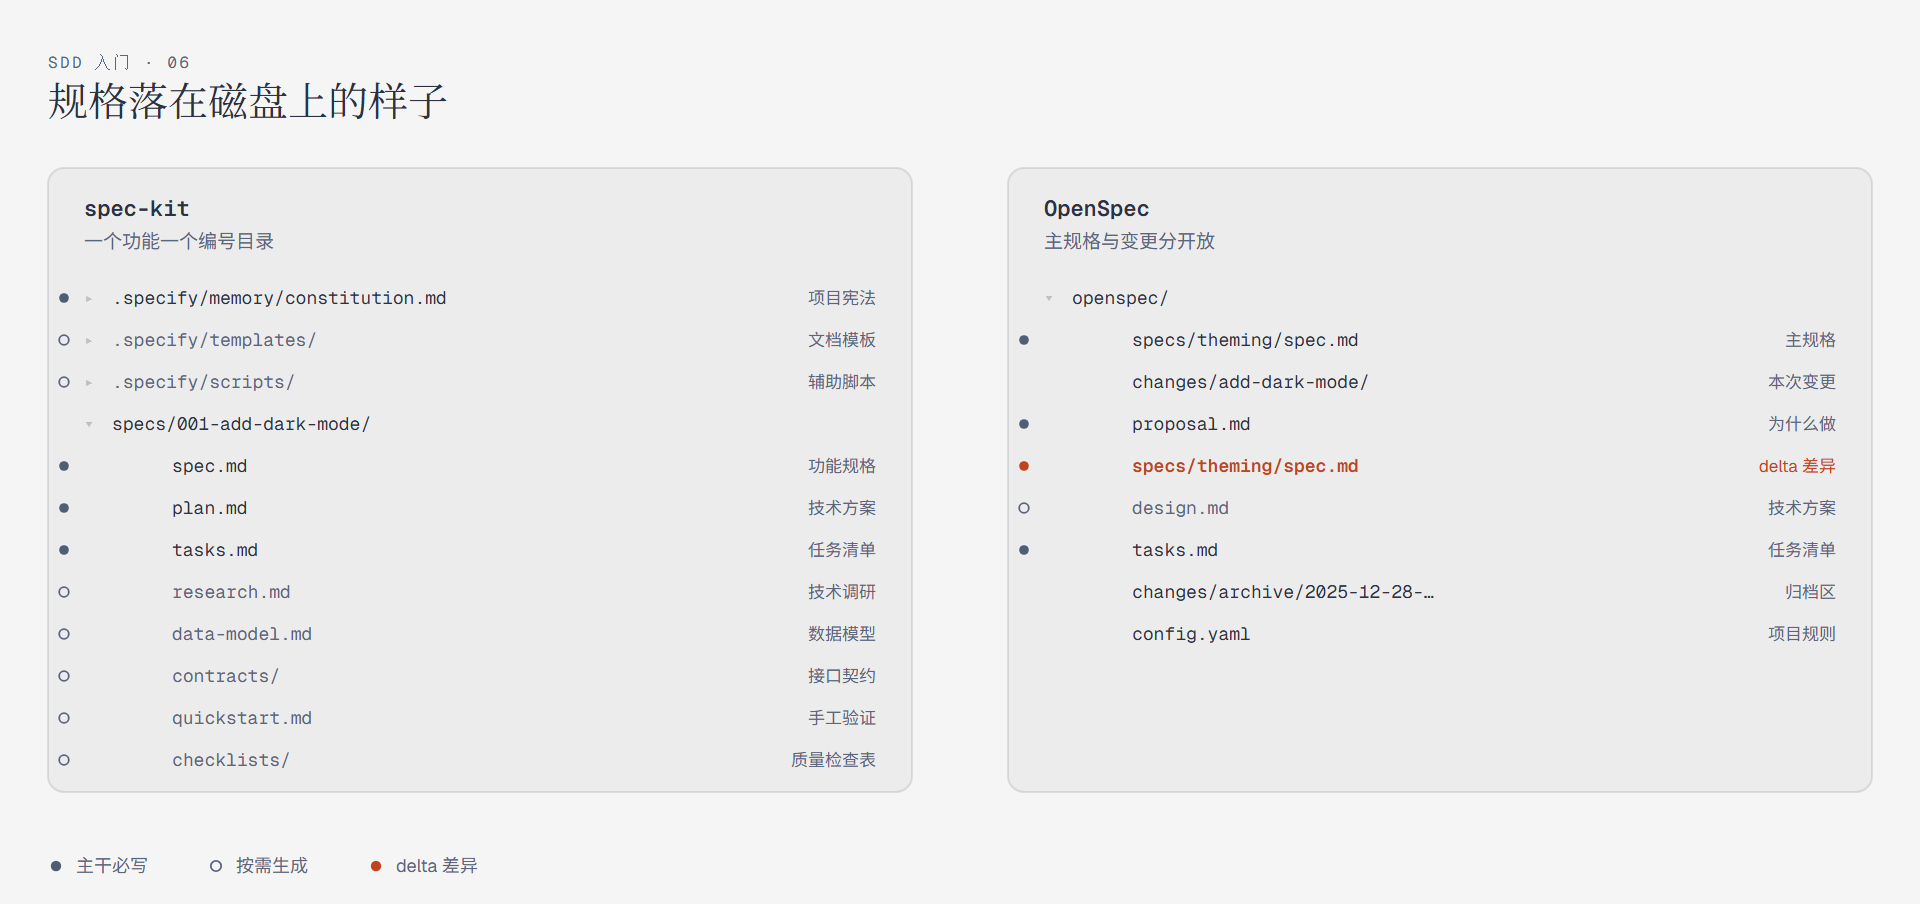
spec-kit 这边,spec.md、plan.md、tasks.md 是主干,每个功能都必须写。research.md 和 data-model.md 只在有技术选型、有实体建模时才生成,contracts/ 只在有对外接口时才生成,quickstart.md 和 checklists/ 属于可选产物。目录名前缀是自动分配的编号,同时会建一个同名分支。
OpenSpec 这边,specs/ 是系统当前行为的权威描述,changes/ 是正在进行的变更。变更规格只写差异,不重复主规格里已有的内容,用四个固定小节区分动作:## ADDED Requirements 表示新增,## MODIFIED Requirements 表示修改,## REMOVED Requirements 表示删除,## RENAMED Requirements 表示改名。改和删都必须写清原因和迁移方式,否则归档时历史决策就丢了。每条需求下面挂场景,格式固定成 #### Scenario: 加 WHEN/THEN,因为归档时工具要按这个结构把差异合并进主规格。
归档是 OpenSpec 最有辨识度的设计。变更做完执行 /opsx:archive,变更目录整体移到 changes/archive/,同时把 delta 合并进 openspec/specs/,主规格始终等于系统当前的真实行为。spec-kit 没有这层机制,它的 specs/001-add-dark-mode/ 做完就留在原地,历史靠 git 分支和目录编号管理。
SDD 与 TDD、BDD 的关系
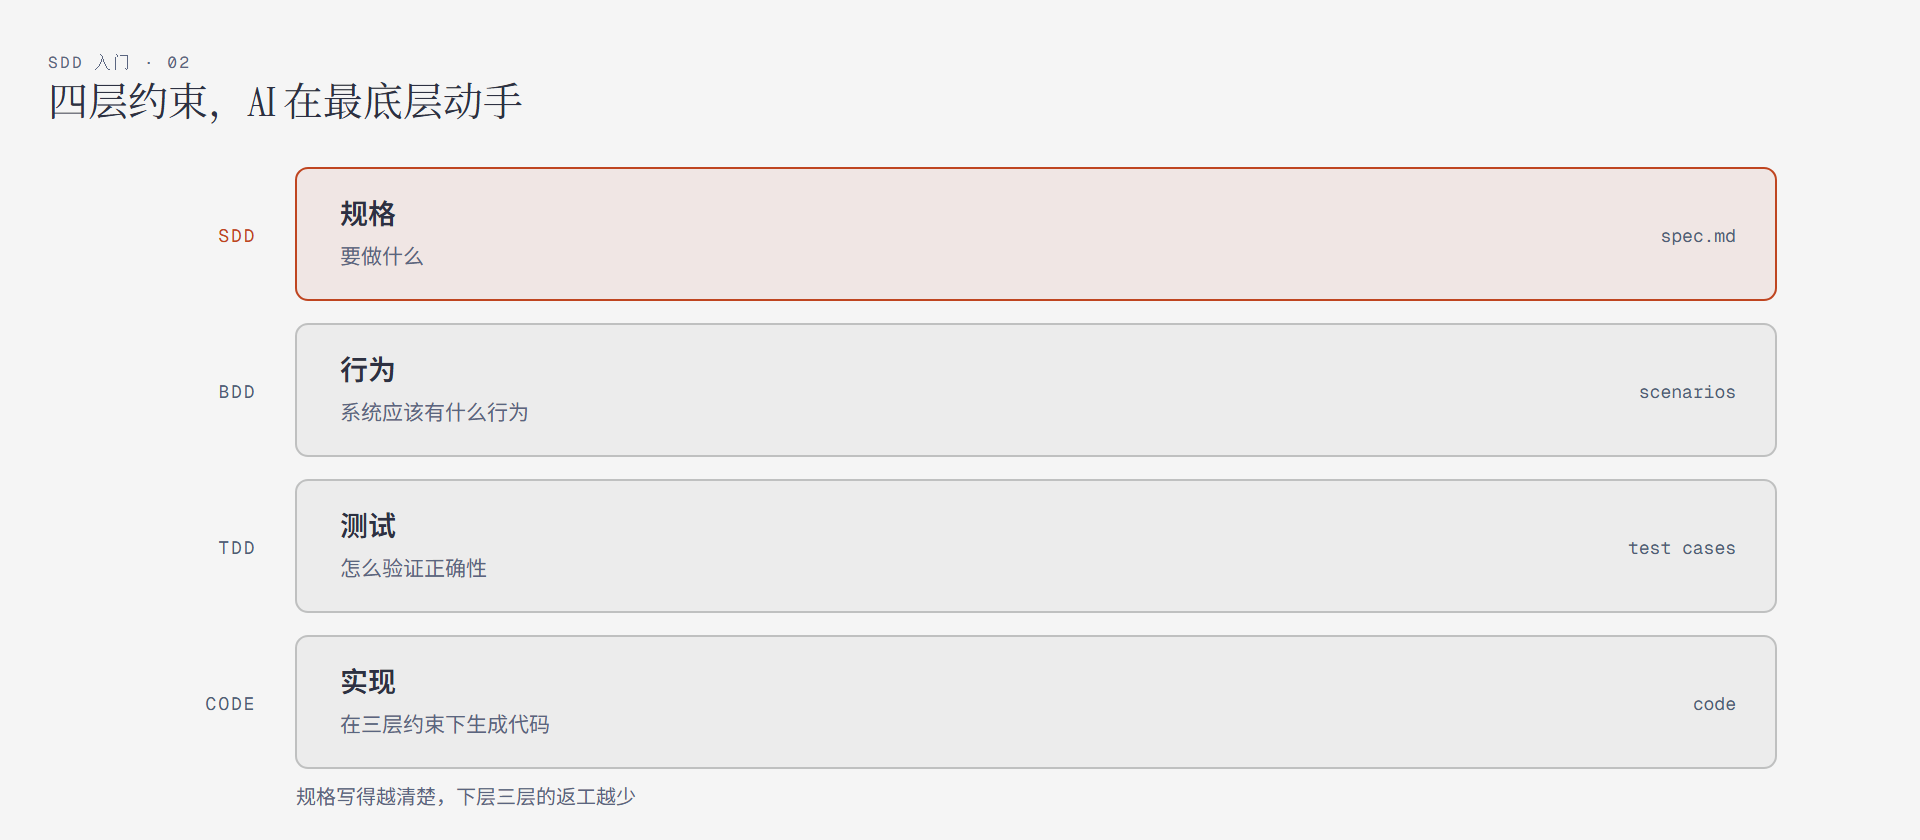
SDD 不是替代 TDD 和 BDD,而是在它们之上增加了一层规格约束。SDD 在最上层定义要做什么,BDD 在中间层定义系统应该有什么行为,TDD 在底层定义怎么验证正确性,最后的代码实现受这三层约束。AI 不是自由发挥,而是在规格、行为和测试三重约束下生成代码。
| 层次 | 关注点 | 回答的问题 |
|---|---|---|
| SDD | 规格 | 要做什么 |
| BDD | 行为 | 系统应该有什么行为 |
| TDD | 测试 | 怎么验证正确性 |
| 实现 | 代码 | AI 在上述三层约束下生成 |
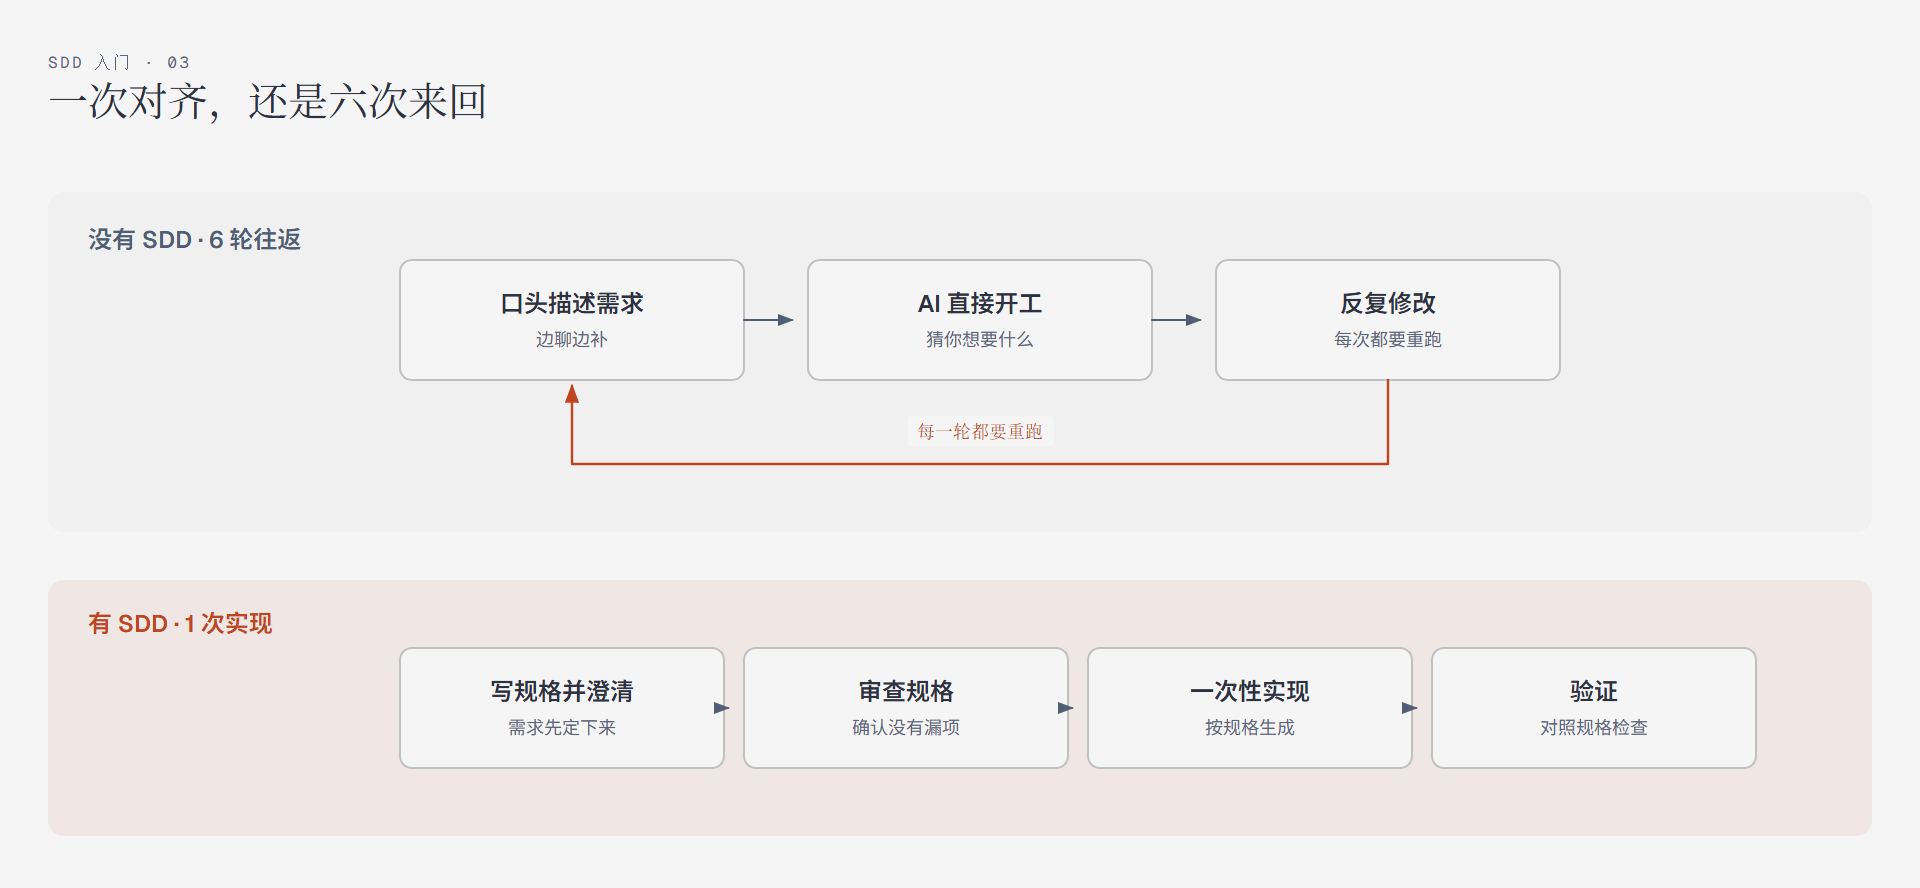
有 SDD 和没有 SDD 的工作流对比
没有 SDD 时,需求和 AI 在对话中不断补充,来回修改效率很低。
1 | 你:帮我加个深色模式 |
有 SDD 时,先对齐要做什么,再一次性实现,减少了来回修改的开销。
1 | 你:/opsx:propose "添加深色模式" |
支持的 Code Agent
| Code Agent | spec-kit 支持 | OpenSpec 支持 |
|---|---|---|
| Claude Code | --ai claude |
/opsx:* 命令 |
| Cursor | slash commands | slash commands |
| GitHub Copilot CLI | 原生支持 | skills 模式 |
| Codex CLI | skills 模式 | skills 模式 |
| Windsurf | 支持 | 支持 |
问题澄清模式
前面讲的工作流都有一个前提:开发者知道要做什么。但实际工作中经常遇到模糊需求,比如想给博客加个评论功能但不知道怎么设计,或者用户反馈搜索太慢但不清楚具体慢在哪里。这时候澄清模式就派上用场了。
| 澄清前 | 澄清后 |
|---|---|
| 我想加评论功能(模糊) | 评论需要登录、支持楼中楼最多 3 层、可编辑删除、需管理员审核(清晰) |
| 搜索太慢(笼统) | 首页搜索接口响应 3s+,原因是全文检索没走索引,需优化 SQL 加缓存(具体) |
| 提升用户体验(抽象) | 页面加骨架屏、关键操作加确认弹窗、表单加实时校验提示(可落地) |
很多项目的返工和延期根因都在这里:需求理解偏差导致做出来的东西不是想要的,边界没定清楚导致范围不断膨胀,技术路线没探索充分导致方案选错。SDD 的澄清模式帮你把这些问题前置到编码之前解决。
两个工具都内置了澄清能力,只是安放的位置不同。spec-kit 把澄清做成流程里的一个正式步骤,专门补规格的漏洞;OpenSpec 把它做成流程之外的开放环节,重点是想清楚要不要做、做哪几件事。
spec-kit 的 clarify:给规格打补丁
/speckit.clarify 必须跑在 /speckit.specify 之后,因为它读的对象就是刚生成的那份 spec.md。运行后 AI 先按一张固定检查表扫一遍规格,覆盖功能边界、数据模型、交互流程、非功能指标、外部依赖、异常处理、术语一致性这些维度,逐项标出清晰程度,再按影响力和不确定性排出问题队列。
提问阶段有三条硬约束:一次只问一个,全程最多五个,每个问题要么给两到五个互斥选项,要么要求用五个词以内回答。选项会带一个推荐项和推荐理由,回复 yes 就是采纳推荐,能省掉不少纠结时间。
1 | 你:/speckit.clarify |
答案不会单独存成一个澄清文件,而是直接改进 spec.md:术语类的答案统一全文用词,数据类的答案补进数据模型,模糊形容词换成可度量的指标。每答完一个就立刻写盘,中途断掉也不会丢。跑完之后 spec.md 里会留下一个 ## Clarifications 小节记录问答历史,同时相关章节已经被就地改写,读规格的人不需要在多个文件之间跳来跳去。
五个问题问完还有没覆盖到的维度,报告里会标成 Deferred,交给 /speckit.plan 阶段处理。这个上限是刻意的,澄清的目的是防止大方向跑偏,不是把所有细节都在规格阶段定死。
OpenSpec 的 explore:动手之前先想明白
/opsx:explore 不产出正式规格,开的是一段自由对话。你可以让它先翻代码看清现状,也可以让它列几种方案比一比,还可以画个草图讨论数据结构。想清楚之后再决定要不要开变更、开几个变更,不必为一个还没想明白的问题先建一堆文档。
1 | 你:/opsx:explore "用户反馈搜索太慢,想优化一下" |
安装步骤
spec-kit 安装
1 | # 方式一:推荐安装稳定版本(v0.6.1) |
初始化项目:
1 | # 创建新项目 |
OpenSpec 安装
1 | # 需要 Node.js 20.19.0+ |
实战示例:为博客添加深色模式
同一个需求,两个工具的走法完全不同。spec-kit 把它拆成九个命令,每个命令产出一两份文档,每一步都能停下来检查;OpenSpec 的命令看着更多,但主路径只有四五个动作,中间的文档由 AI 连续生成。下面用深色模式各跑一遍。
spec-kit 的九个命令
先看清单,注意不是每个都必须用。
| 命令 | 作用 | 使用时机 | 产物 |
|---|---|---|---|
/speckit.constitution |
定项目宪法:技术栈、代码规范、测试要求 | 每个项目一次 | .specify/memory/constitution.md |
/speckit.specify |
用一段话描述需求,生成功能规格 | 每个功能一次 | specs/001-xxx/spec.md |
/speckit.clarify |
扫出规格里没说清的地方并提问 | 规格写完后 | 答案写回 spec.md |
/speckit.checklist |
生成需求质量检查表 | 需求复杂时 | checklists/*.md |
/speckit.plan |
定技术方案、查清技术选型 | 规格确认后 | plan.md、research.md、data-model.md、contracts/ |
/speckit.tasks |
拆成按依赖排序的任务 | 方案确认后 | tasks.md |
/speckit.analyze |
只读检查三份文档是否一致 | 开工之前 | 一份报告,不改任何文件 |
/speckit.implement |
逐项执行任务并写代码 | 检查通过后 | 代码,任务被勾掉 |
/speckit.taskstoissues |
把任务转成 GitHub Issue | 多人协作时 | 一批 Issue |
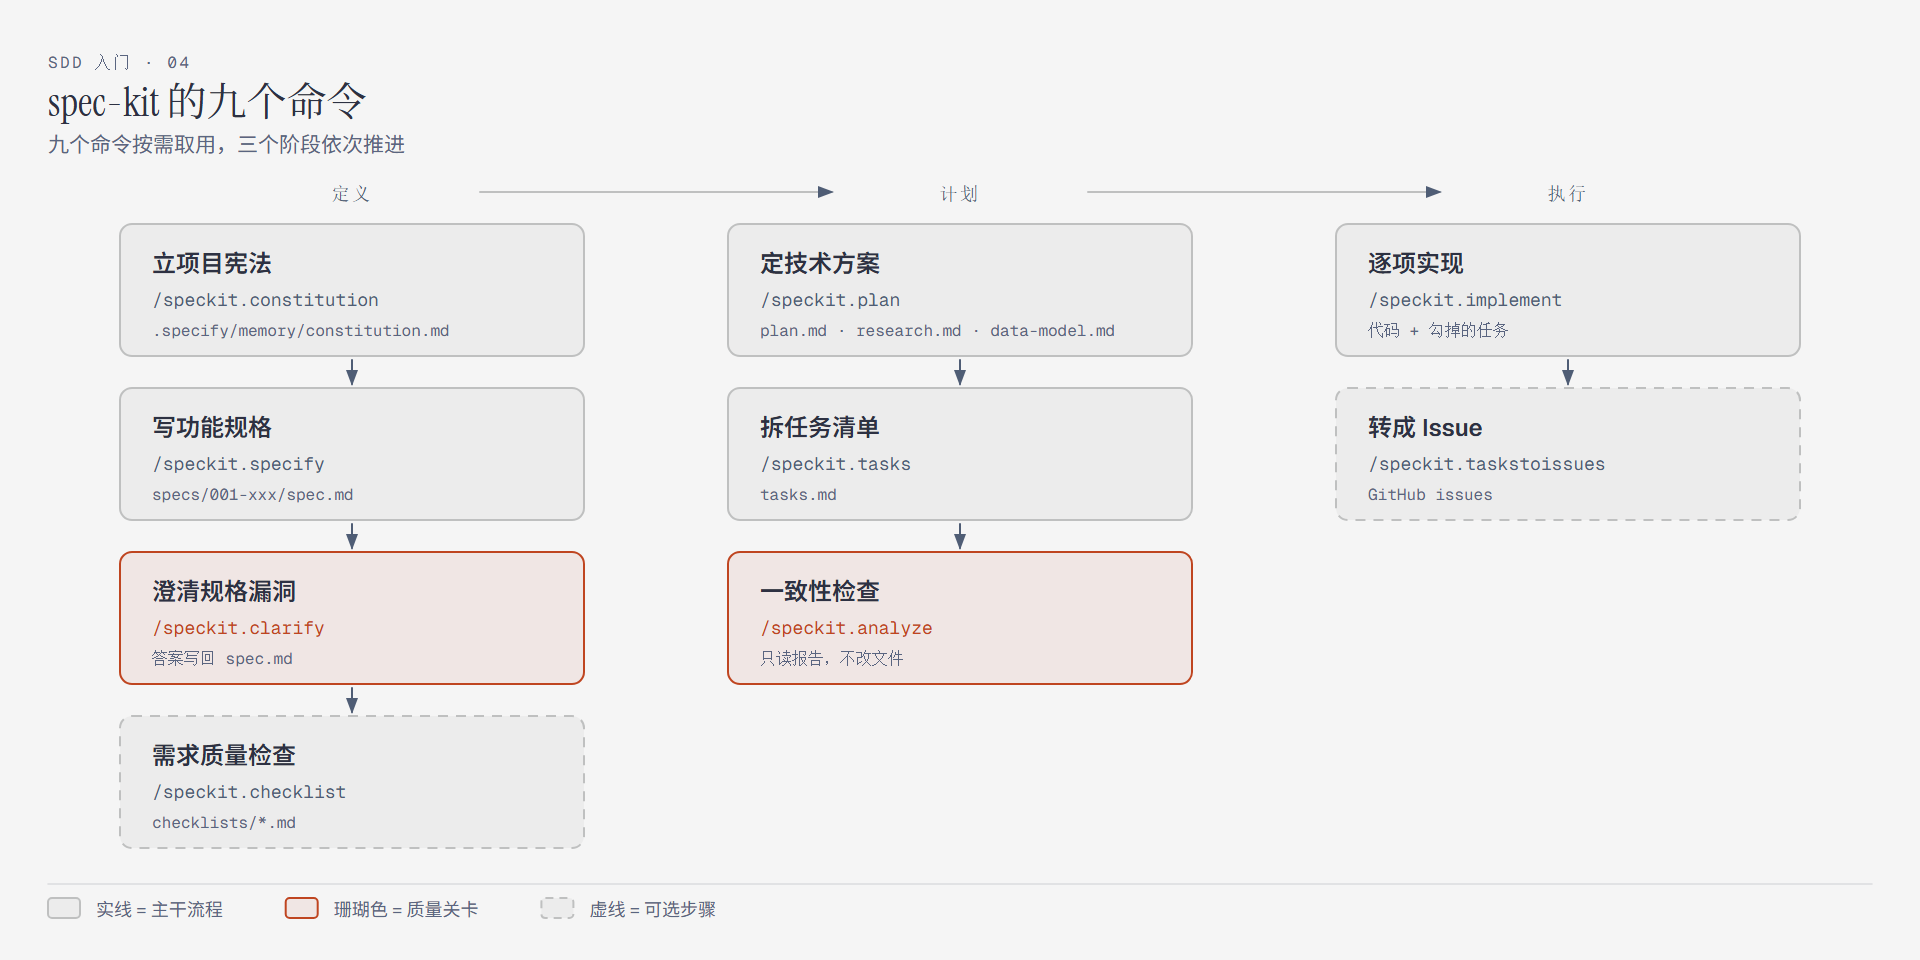
第一步,立规矩。执行 /speckit.constitution,把技术栈、代码风格、测试覆盖率要求、文档要求讲清楚。这些内容写进 .specify/memory/constitution.md,之后每次生成方案和任务都会被读进去当约束,方案里还会出现一段 Constitution Check 逐条对照。这个命令一个项目跑一次就够,规范变了再跑一次做修订。
第二步,写规格。执行 /speckit.specify 并描述需求:
1 | 你:/speckit.specify 给博客加深色模式,支持亮色、深色、跟随系统三种模式, |
这一步只描述要什么,不提怎么实现。spec.md 里不该出现 React Context、CSS 变量这类技术名词,那是 plan 阶段的事。混进来就会导致 AI 过早锁定实现方式,规格也跟着失去可选空间。
第三步,澄清。执行 /speckit.clarify,AI 扫出规格里没写清的地方逐个提问,细节见上一节。深色模式这个需求通常命中的问题是:用户手动切过模式之后,跟随系统这一档还要不要保留、首屏渲染时怎么避免白屏闪烁、第三方组件没适配深色怎么处理。
第四步,技术方案。执行 /speckit.plan,AI 生成 plan.md,同时做技术调研并把结论写进 research.md,涉及实体的部分写进 data-model.md。plan.md 里会包含技术选型(用 CSS 变量还是 styled-components)、要改的文件清单、分几个阶段实施。
第五步,拆任务。执行 /speckit.tasks,生成的任务清单大致是这样:
1 | ## Tasks |
第六步,一致性检查。执行 /speckit.analyze,它只读不写,专门找三类问题:规格里写了但任务里没覆盖的需求、plan 里出现但规格里没提的实现细节、同一个概念在两份文档里叫法不一致。任务是从 plan 生成的,plan 是从 spec 生成的,一路传下来难免丢东西,这一步就是把漏掉的捡回来。
第七步,实施。执行 /speckit.implement,AI 按任务清单逐项实现,每完成一项把 - [ ] 改成 - [x],遇到卡住的地方会停下来问你。命令不用带功能名,它认的是当前分支。
需要同步到 GitHub 的话,最后跑一次 /speckit.taskstoissues,它按依赖顺序建 Issue,多人分头做的时候比较省事。
OpenSpec 的十个命令
OpenSpec 的命令更多,但每个都更轻。
| 命令 | 作用 | 使用时机 | 产物 |
|---|---|---|---|
/opsx:onboard |
带你在真实项目里走一遍完整流程 | 第一次接触 | 无,纯讲解 |
/opsx:explore |
只聊不做,把模糊需求聊清楚 | 需求没想清时 | 讨论结论,可选落盘 |
/opsx:new |
建一个变更目录,之后一次生成一份文档 | 常规启动 | changes/<name>/ 骨架 |
/opsx:continue |
生成下一份该写的文档 | 想逐步确认 | 按顺序产出四份文档 |
/opsx:ff |
把剩下的文档一次全部生成 | 想省时间 | 同上,一次到位 |
/opsx:propose |
一句话描述,直接生成到可实施状态 | 需求已经很明确 | 全套文档 |
/opsx:apply |
按 tasks.md 逐项实现,边做边勾 | 开始写代码 | 代码,任务被勾掉 |
/opsx:verify |
对照规格和任务检查实现有没有漏 | 实施完成后 | 三维度检查报告 |
/opsx:sync |
把变更规格合并进主规格,不归档 | 想先更新主规格 | 更新 openspec/specs/ |
/opsx:archive |
归档变更,顺带同步主规格 | 确认完成 | 移入 changes/archive/ |
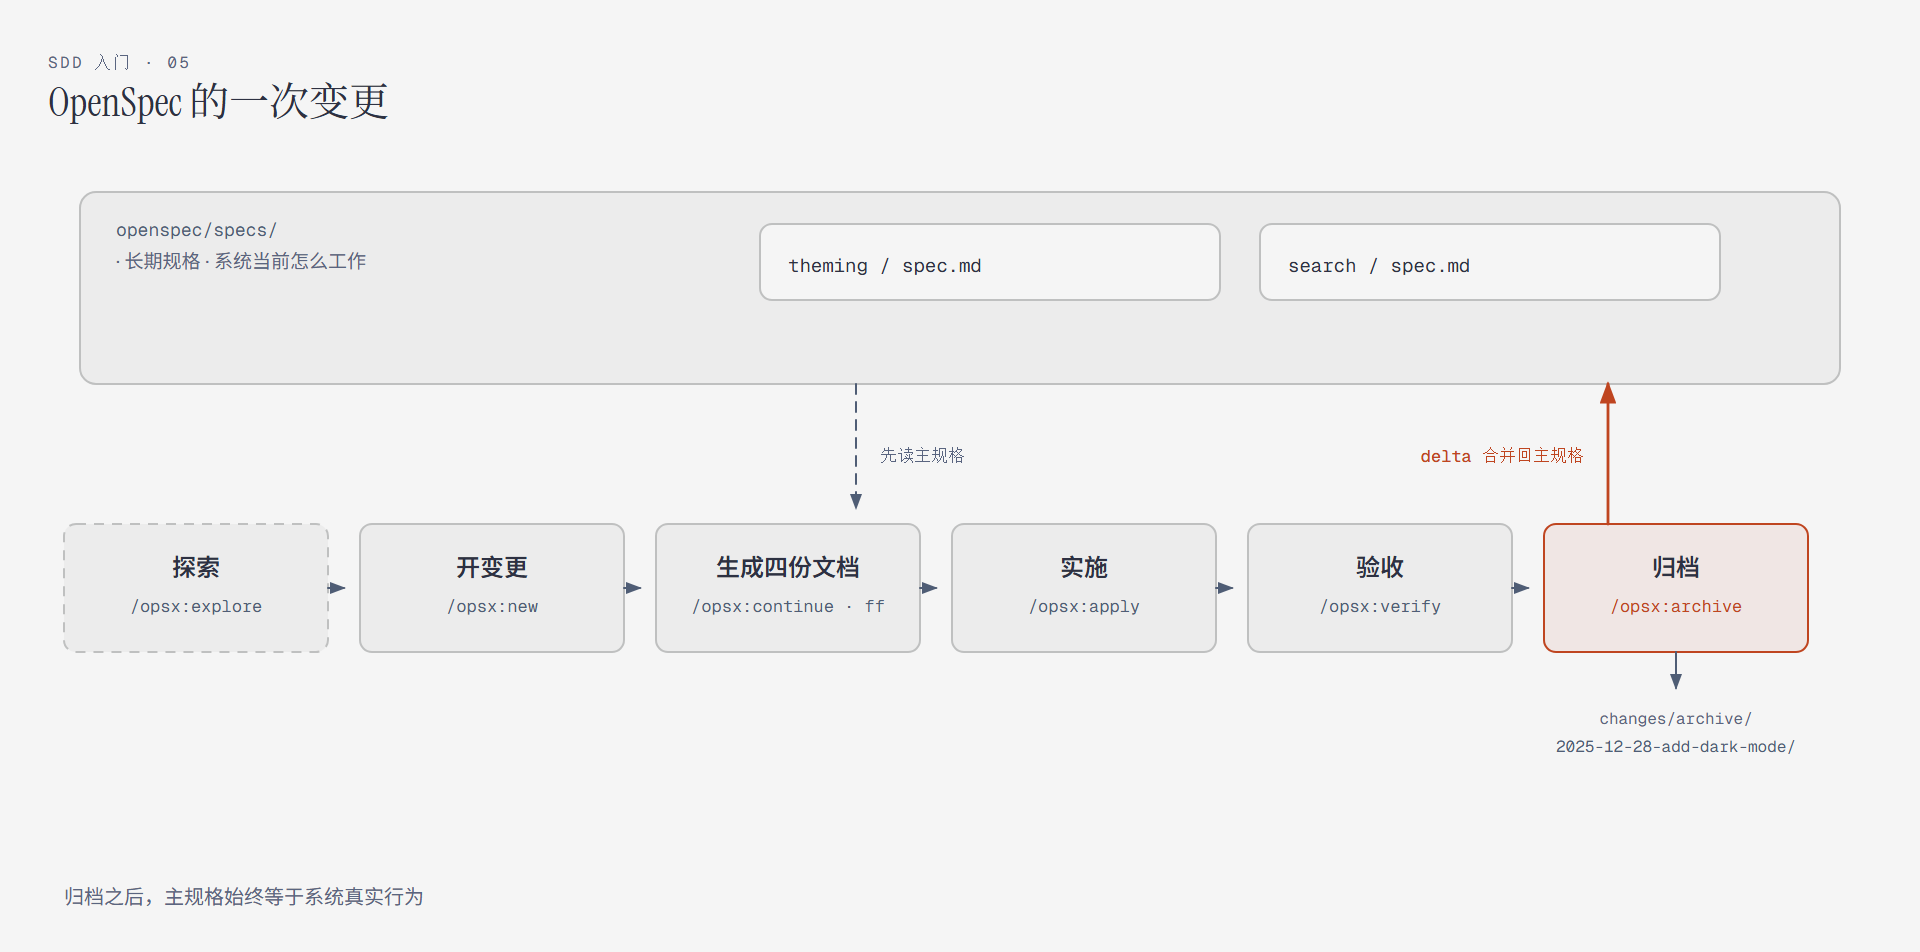
new、continue、ff、propose 这四个最容易混。它们的关系是:new 只建目录,continue 每跑一次生成一份文档,ff 把剩下的文档一次生成完,propose 从一句描述直接生成到可实施状态。想逐步审查就用 new 加 continue,赶时间就用 propose。
第一步,初始化。执行 openspec init 之后项目里会多出 openspec/ 目录和一套 /opsx:* 命令。config.yaml 里可以写清项目技术栈和每类文档的额外规则,AI 之后生成文档时会读。
第二步,要不要先探索。需求模糊就先 /opsx:explore,需求已经明确就直接进下一步。深色模式这种需求通常不需要探索。
第三步,开变更。执行 /opsx:new add-dark-mode,AI 建好目录后提示先写 proposal。之后每执行一次 /opsx:continue 生成一份文档,顺序由工作流配置决定,默认是 proposal 先写,然后 specs 和 design,最后 tasks。tasks 依赖前面两份都完成,所以顺序不能乱。
proposal 定的是为什么做、改哪些能力、影响哪些代码。specs 给每个能力写一份 delta 规格。design 只在变更涉及架构、外部依赖或者数据模型时才写,一个小改动可以跳过。
第四步,审查规格。打开 changes/add-dark-mode/specs/theming/spec.md,在 ## MODIFIED Requirements 下面补一条需求:切换按钮要显示当前模式图标。直接改文件就行,AI 下一轮读到的就是改后的版本。
第五步,实施。执行 /opsx:apply,AI 按任务清单逐项实现并勾掉:
1 | AI: Implementing tasks... |
第六步,验收。执行 /opsx:verify,它从三个维度检查:任务是不是全部完成、规格里每条需求是不是都有对应实现、文档和代码之间有没有互相矛盾的地方。结果是一份报告,发现问题会指到具体文件和行。
第七步,归档。执行 /opsx:archive,变更目录整体移到 changes/archive/2025-12-28-add-dark-mode/,同时把 delta 合并进 openspec/specs/theming/spec.md。合并前它会列一遍要做的增删改让你确认,如果主规格已经被别处改过,会先比对差异再决定怎么合。
同一个变更用两边各走一遍,取向差异就很明显了。spec-kit 让你在每一步都停下来看一眼,代价是命令多、文档多;OpenSpec 让你把注意力放在 proposal 和 specs 上,代价是中间过程不透明,得回过头翻文件才知道 AI 生成了什么。
spec-kit vs OpenSpec 怎么选
| 维度 | spec-kit | OpenSpec |
|---|---|---|
| 出品方 | GitHub 官方 | Fission AI(创业公司) |
| 风格 | 工程化、严谨 | 灵活、快速 |
| 安装 | Python + uv | Node.js + npm |
| 流程 | 分步执行,九个命令按需取用 | 主路径四五个动作,文档由 AI 连续生成 |
| 扩展性 | 40+ 官方扩展 | 配置化定制 |
| 适合场景 | 大型项目、团队协作 | 个人项目、快速迭代 |
| 学习曲线 | 较陡(概念多) | 较平(上手快) |
选择建议:大型团队或 Python 项目选 spec-kit,个人开发者或 TypeScript 项目选 OpenSpec。如果想快速体验 SDD 的流程,可以先试 OpenSpec 再系统学习 spec-kit。
SDD 的核心价值在于把质量关口前移到规格阶段。当 AI 能够根据规格生成代码时,规格的质量直接决定了生成代码的质量。与其在实现过程中反复返工,不如在动手之前先把需求聊清楚。
参考资料
- GitHub spec-kit — 87k+ Stars
- Fission-AI OpenSpec — 39k+ Stars
- The Rise of SDD in the AI Era
- SDD Complete Guide